Gemini 3.7 Flash API 활용법과 요금 정리
목차
Gemini 3.7 Flash란? 3.6 Flash 후속 모델의 등장 배경
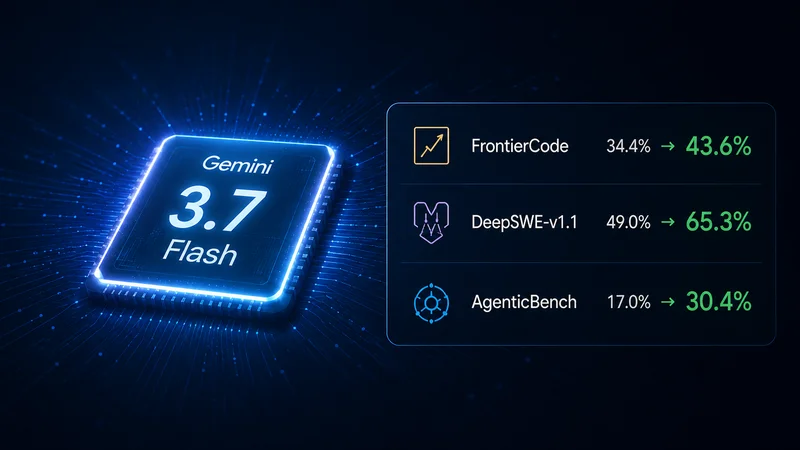
Gemini 3.7 Flash는 구글이 2026년 8월 13일 공식 발표한 모델로, 직전 버전인 Gemini 3.6 Flash가 나온 지 불과 3주 만에 출시됐습니다. 구글은 이 모델을 "코딩과 에이전트를 위한 가장 지능적인 워크호스 모델(most intelligent workhorse model yet for coding and agents)"로 포지셔닝했습니다. 짧은 출시 간격에도 불구하고 구글이 공식 발표에서 제시한 벤치마크 수치는 구체적입니다.
구글 공식 발표 기준 — 코드품질 벤치마크 FrontierCode 43.6%(3.6 Flash 대비 34.4%), 소프트웨어 엔지니어링 벤치마크 DeepSWE v1.1 65.3%(대비 49.0%), 자동화 워크플로 벤치마크 AutomationBench 30.4%(대비 17.0%)로 세 지표 모두 전작 대비 상승했습니다.
단순히 "품질이 좋아졌다"는 식의 서술이 아니라, 세 벤치마크 모두 두 자릿수 퍼센트포인트 차이로 개선됐다는 점이 이번 발표의 핵심입니다. 특히 AutomationBench(자동화 워크플로 평가)에서 17.0%에서 30.4%로 오른 것은 반복 작업을 맡기는 에이전트 용도에서 체감 차이가 클 수 있는 수치입니다.
핵심 스펙: 컨텍스트 윈도우와 사고 수준
컨텍스트 윈도우와 출력 토큰 한도
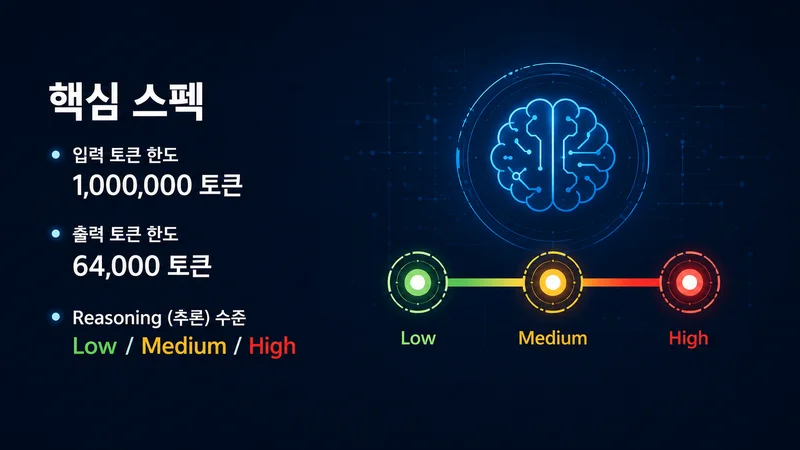
Gemini 3.7 Flash의 컨텍스트 윈도우(모델이 한 번의 요청에서 참조할 수 있는 입력 토큰의 총량)는 최대 100만(1M) 토큰입니다. 긴 코드베이스나 여러 개의 문서를 한 번에 넣고 질의할 때 이 한도 안에서는 별도의 청크 분할 없이 처리할 수 있습니다. 최대 출력 토큰은 6.4만(64K) 토큰으로, 긴 리포트나 대규모 코드 생성 결과물도 한 번의 응답으로 받을 수 있는 수준입니다.
사고 수준(Thinking Level) 3단계 조정
Gemini 3.7 Flash는 하이브리드 추론 구조를 유지하면서 사고 수준(thinking level)을 low·medium·high 3단계로 조정할 수 있습니다. 사고 수준을 낮추면 응답 속도가 빨라지고 비용이 줄어들며, 높이면 복잡한 코드 리팩터링이나 다단계 에이전트 작업에서 정확도가 올라가는 트레이드오프 구조입니다. 기존에 써왔던 사고 예산(Thinking Budget) 방식과 유사하게, 작업 난이도에 따라 API 호출 시점에 값을 바꿔줄 수 있습니다.
Gemini 3.7 Flash API 요금표
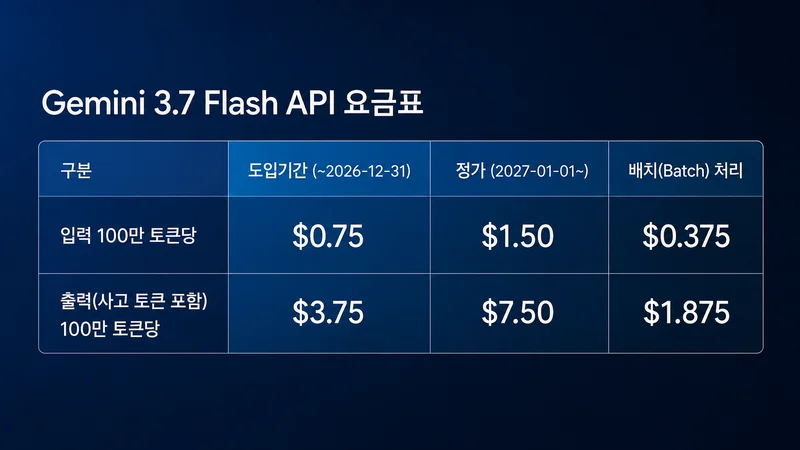
요금 계획을 세울 때 가장 먼저 확인해야 할 것은 도입기간과 정가의 차이입니다. 구글 공식 요금표 기준으로 2026년 12월 31일까지는 도입기간 할인가가 적용되고, 2027년 1월 1일부터는 정가로 전환됩니다.
| 구분 | 도입기간 (~2026-12-31) | 정가 (2027-01-01~) | 배치(Batch) 처리 |
|---|---|---|---|
| 입력 100만 토큰당 | $0.75 | $1.50 | $0.375 |
| 출력(사고 토큰 포함) 100만 토큰당 | $3.75 | $7.50 | $1.875 |
2027년 1월 1일부터는 입력·출력 요금이 도입기간 대비 약 2배로 인상됩니다. 장기 프로젝트나 반복 배치 작업을 계획 중이라면, 올해 안에 트래픽을 늘려 도입기간 혜택을 최대한 활용하는 편이 비용 계획상 유리합니다.
Gemini 3.7 Flash API 연동 및 실전 코드
실제로 API를 붙일 때는 앞서 정리한 요금 구조와 스펙을 먼저 감안하는 것이 좋습니다. 입력·출력 요금이 다르고 사고 토큰까지 출력 요금에 포함되기 때문에, 사고 수준을 high로 고정해두면 간단한 질의에도 사고 토큰 비용이 누적될 수 있습니다. 아래는 파이썬 SDK로 사고 수준을 지정해 호출하는 예시입니다.
from google import genai
from google.genai import types

client = genai.Client(api_key="YOUR_API_KEY")

response = client.models.generate_content(
    model="gemini-3.7-flash",
    contents="이 함수의 시간복잡도를 분석하고 개선안을 제시해줘",
    config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(
            thinking_level="medium"  # low / medium / high
        ),
        max_output_tokens=8192
    )
)

print(response.text)
print(response.usage_metadata)  # 입력/출력/사고 토큰 사용량 확인
간단한 코드 리뷰나 자동완성 수준의 작업은 thinking_level="low"로도 충분한 경우가 많고, 여러 파일을 넘나드는 리팩터링이나 에이전트 워크플로에는 "high"가 적합합니다. usage_metadata로 실제 사용된 사고 토큰 수를 확인해가며 단계를 조정하면 요금표의 출력 단가($3.75/1M, 도입기간 기준)를 불필요하게 낭비하지 않을 수 있습니다.
실무 도입 절차 및 주의사항
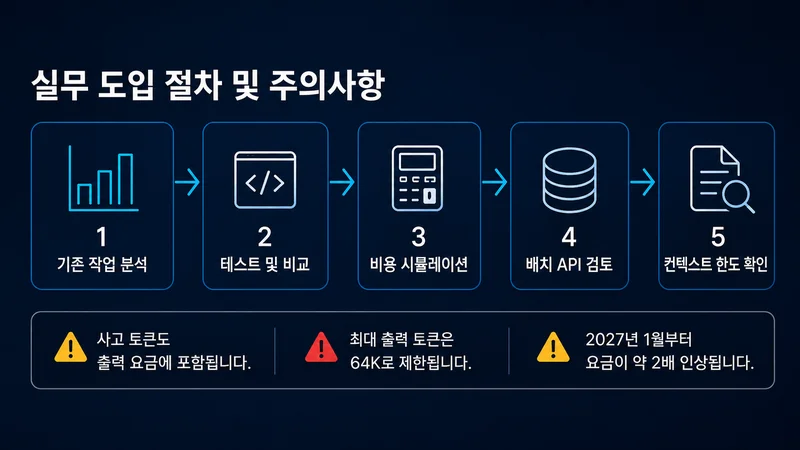
실무에 붙이기 전에는 아래 순서로 점검하는 것을 권장합니다.
- 기존에 Gemini 3.6 Flash나 다른 모델로 처리하던 작업의 평균 입출력 토큰 수를 파악한다.
- 사고 수준(low/medium/high)별로 소규모 테스트를 돌려 응답 품질과 지연 시간을 비교한다.
- 도입기간 요금(입력 $0.75·출력 $3.75)으로 예상 월 비용을 계산하고, 2027년 정가($1.50·$7.50) 적용 시 비용도 함께 시뮬레이션해둔다.
- 대량 처리가 필요한 배치성 작업은 배치 API(입력 $0.375·출력 $1.875)로 분리할 수 있는지 검토한다.
- 100만 토큰 컨텍스트를 활용할 계획이라면 실제 입력 문서 길이가 한도 내에 들어오는지 사전에 확인한다.
주의할 점도 몇 가지 있습니다.
- 출력 요금에는 사고 토큰(thinking token)이 포함되므로, 사고 수준을 무조건 high로 고정하면 체감 비용이 예상보다 커질 수 있습니다.
- 최대 출력 토큰은 64K로 고정되어 있어, 이보다 긴 결과물이 필요한 작업은 여러 번의 호출로 나누는 구조를 미리 설계해야 합니다.
- 2027년 요금 인상 시점을 감안해, 장기 계약이나 연간 예산을 짤 때는 도입기간과 정가 구간을 나눠 계산해두는 것이 안전합니다.
참고로 같은 시기 다른 모델의 API 요금 변화를 비교해보고 싶다면 Claude Sonnet5 가격 인하 글에서 Pro 구독과 API 종량제 비교를 참고할 수 있고, 코딩 작업에 어떤 모델을 붙일지 고민된다면 Kimi K3 vs GPT-5.6 vs Claude 비교 글도 함께 참고할 만합니다.
자주 묻는 질문
Q. Gemini 3.7 Flash와 3.6 Flash의 차이는 무엇인가요?
구글 공식 발표 기준으로 코드품질 벤치마크 FrontierCode가 34.4%에서 43.6%로, 소프트웨어 엔지니어링 벤치마크 DeepSWE v1.1이 49.0%에서 65.3%로, 자동화 워크플로 벤치마크 AutomationBench가 17.0%에서 30.4%로 개선됐습니다. 출시 간격은 3주로 짧았지만 세 지표 모두 수치상 상승이 확인됩니다.
Q. API 요금은 언제부터 오르나요?
2026년 12월 31일까지는 도입기간 할인가(입력 100만 토큰당 $0.75, 출력 $3.75)가 적용되고, 2027년 1월 1일부터는 정가(입력 $1.50, 출력 $7.50)로 전환되어 약 2배 인상됩니다.
Q. 배치(Batch) API를 쓰면 얼마나 저렴한가요?
도입기간 기준 배치 처리 요금은 입력 100만 토큰당 $0.375, 출력 $1.875로, 실시간 호출 대비 절반 수준입니다. 실시간 응답이 필요 없는 대량 처리 작업이라면 배치 API로 분리하는 것이 비용 측면에서 유리합니다.
Q. 사고 수준(thinking level)은 어떻게 선택해야 하나요?
간단한 코드 자동완성이나 짧은 질의응답은 low로도 충분한 경우가 많고, 여러 파일을 넘나드는 리팩터링이나 다단계 에이전트 작업에는 high가 적합합니다. 사고 토큰도 출력 요금에 포함되므로 응답 품질과 비용을 함께 보며 단계를 조정하는 것이 좋습니다.
Q. 컨텍스트 윈도우 100만 토큰을 실제로 다 쓸 수 있나요?
스펙상 최대 100만 토큰까지 입력 가능하지만, 최대 출력은 6.4만 토큰으로 별도 제한됩니다. 긴 입력을 넣고 긴 출력을 동시에 요구하는 작업이라면 출력 한도를 먼저 확인하고 여러 번 호출로 나누는 구조를 설계해야 합니다.