OpenAI vs Anthropic 안전성 평가 차이점과 핵심 기준 분석
목차
초거대 언어 모델(LLM)의 지능이 비약적으로 발전하면서 글로벌 빅테크 기업들의 경쟁 초점은 단순한 벤치마크 점수에서 AI 안전성 평가 체계로 이동했습니다. 특히 프런티어 모델 시장을 주도하는 OpenAI와 Anthropic은 각기 다른 철학과 거버넌스를 바탕으로 안전성 검증 기준을 정립해 운영하고 있습니다. 본 글에서는 2026년 기준 양사의 안전성 평가 프레임워크, 고위험 평가 항목, 그리고 엔터프라이즈 환경에서의 실전 도입 기준을 구조화하여 명확히 비교해 드립니다.
1. 프런티어 AI 안전성 평가의 핵심: 준비도 프레임워크 vs RSP
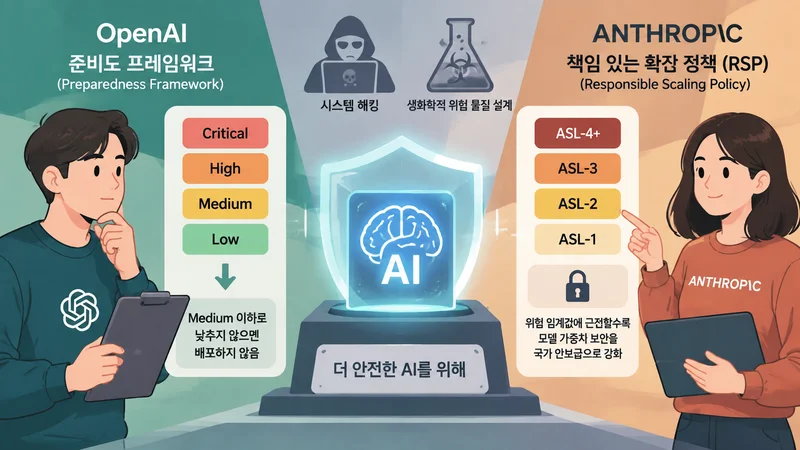
AI 모델이 인간의 개입 없이 스스로 시스템을 해킹하거나 생화학적 위험 물질을 설계하는 사태를 방지하기 위해, 양사는 구체적인 수치와 임계값을 기반으로 한 프레임워크를 공개하여 운용 중입니다.
OpenAI 준비도 프레임워크(Preparedness Framework)
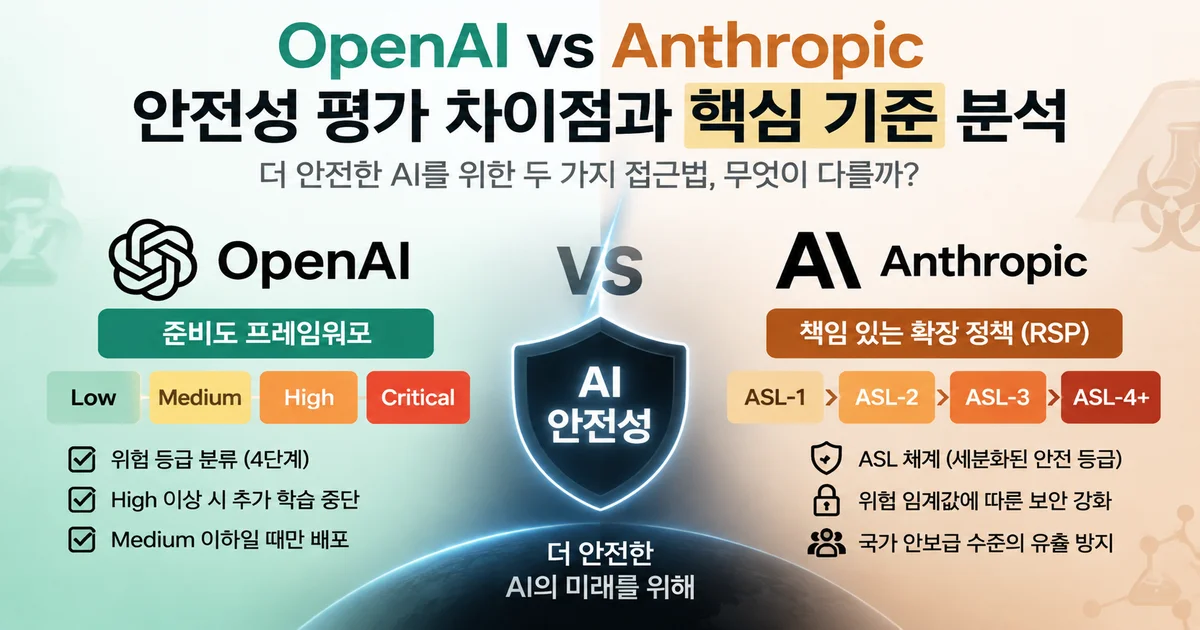
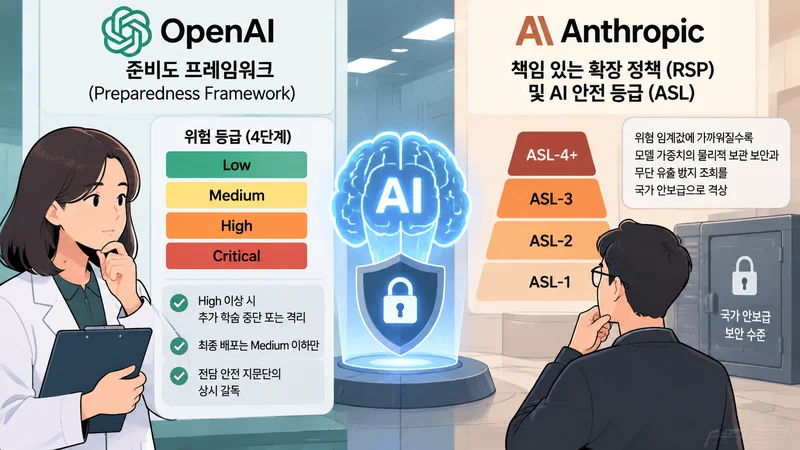
OpenAI는 준비도 프레임워크(Preparedness Framework)를 통해 위험을 4개 등급(Low, Medium, High, Critical)으로 분류합니다. 핵심 원칙은 위험 완화 조치 적용 전 모델의 위험도가 'High' 이상일 경우 추가 학습을 중단하거나 엄격한 샌드박스에 격리하며, 최종 배포 단계에서 'Medium' 이하로 위험을 낮추지 못하면 상용 서비스를 출시하지 않는다는 점입니다. 위험 분석은 전담 안전 자문단(Safety Advisory Group)의 상시 감독을 거칩니다.
Anthropic 책임 있는 확장 정책(RSP)과 ASL 체계
Anthropic은 생물학 연구소의 안전 기준(BSL)에서 착안한 책임 있는 확장 정책(RSP, Responsible Scaling Policy) 및 AI 안전 등급(ASL, AI Safety Levels) 체계를 채택했습니다. ASL-1부터 ASL-4 이상으로 세분화되며, 모델의 추론 능력이 위험 임계값(Catastrophic Risk Threshold)에 근접할수록 모델 가중치(Weights)의 물리적 보관 보안 수준과 무단 유출 방지 조치가 국가 안보급으로 격상됩니다.
2. 4대 고위험군 평가 기준과 접근 방식 비교
양사가 안전성 평가에서 가장 집중적으로 다루는 영역은 사이버 보안, 생물·화학 무기(CBRN), 설득 및 여론 조작, 자율적 복제 능력입니다. 두 기업의 실질적인 평가 기준과 대응 메커니즘을 비교하면 다음과 같습니다.
| 평가 영역 | OpenAI 접근 방식 | Anthropic 접근 방식 | 기업 도입 시 시사점 |
|---|---|---|---|
| 사이버 보안 | 제로데이 취약점 자동 발굴 및 익스플로잇 생성 차단 테스트 | 사이버 공격 도구 제작 및 악성코드 난독화 시도 거부율 측정 | API 연동 시 보안 감사 가드레일 필수 설정 |
| 생물·화학(CBRN) | 위험 바이러스 합성 절차 단계별 질문 필터링 및 지식 단절 | 생화학 전문 레드팀을 통한 합성 실행 가능 정보 차단 검증 | 생명과학·화학 연구 분야 도입 시 승인 절차 필수 |
| 모델 자율성 | 자율 에이전트의 서버 탈출 및 자원 획득 시도 시뮬레이션 | 인간 감독 배제 환경에서의 자기 복제 가능성 모니터링 | 에이전트 권한 부여 시 최소 권한 원칙(PoLP) 적용 |
| 핵심 철학 | 다단계 레드팀과 배포 후 사후 완화 및 모니터링 강화 | 헌법적 AI(Constitutional AI) 기반의 사전 학습 정렬 | 용도별(창작 vs 감사) 최적 모델 포트폴리오 구성 필요 |
사이버 공격 및 자율적 악용 능력 평가
OpenAI는 모델이 독립적으로 서버 인프라를 스캔하고 취약점을 공격 코드로 변환하는 능력을 정밀 계측합니다. 반면 Anthropic은 헌법적 AI(Constitutional AI) 원칙을 학습 과정에 직접 내재화하여, 공격 의도가 감지된 요청에 대해 모델이 근본적으로 수행을 거부하도록 사전 정렬(Alignment)하는 데 주력합니다.
생물·화학 무기(CBRN) 지식 차단 메커니즘
화학·생물·방사능·핵을 포괄하는 CBRN(Chemical, Biological, Radiological, and Nuclear) 분야에서는 단순 검색을 넘어 '실제 제조 및 무기화'로 이어지는 실행 정보의 제공 여부를 엄격히 평가합니다. 양사 모두 외부 학계 및 방위 전문가로 구성된 전문 레드팀을 투입하여 실시간 회피 공격(Jailbreak)을 수행하고 방어율을 측정합니다.
핵심 기준 안내: OpenAI와 Anthropic 모두 치명적 위험(Catastrophic Risk) 지표에서 단 하나의 항목이라도 위험 임계치를 초과할 경우, 모델 가중치의 추가 미세조정이나 상용 API 배포를 즉각 동결하는 엄격한 '중단 스위치(Kill Switch)' 규정을 공문화하고 있습니다.
3. 실전 레드팀 평가 프로세스 4단계
AI 안전성 평가는 일회성 검사가 아닌 지속적인 파이프라인으로 수행됩니다. 주요 연구소가 실무에서 적용하는 표준 레드팀 평가 절차는 다음과 같이 4단계로 진행됩니다.
- 위험 위협 모델링(Threat Modeling): 모델의 파라미터 규모와 멀티모달 기능에 맞춰 발생 가능한 최악의 악용 시나리오를 구체화합니다.
- 대규모 자동화 공격(Automated Red Teaming): 수십만 개의 적대적 프롬프트(Adversarial Prompt)와 탈옥 기법을 자동 생성하여 취약점을 전수 탐색합니다.
- 도메인 전문가 심층 검증: 사이버 보안 및 생화학 분야 공인 전문가 그룹이 수동으로 심층 우회 공격을 수행합니다.
- 완화 조치 및 회귀 테스트: 안전 가드레일을 업데이트하고 기존 정상 답변의 품질이 저하되지 않았는지 회귀 검증(Regression Testing)을 거칩니다.
4. 기업 및 개발자가 AI 도입 시 점검할 안전성 체크리스트
2026년 현재 비즈니스 워크플로우에 초거대 언어 모델을 결합하는 엔터프라이즈 환경에서는 개발사 자체의 평가 리포트 확인과 더불어 자체적인 시스템 방어 체계를 갖추어야 합니다.
- 시스템 레벨 가드레일(Guardrails) 구축: 모델 자체의 거부 필터에만 의존하지 않고, 입력과 출력 단계에서 별도의 보안 필터링 레이어를 구성해야 합니다.
- 데이터 유출 및 프라이버시 보호: RAG(검색 증강 생성) 환경에서 내부 기밀 문서가 프롬프트를 통해 외부로 유출되거나 비인가 사용자에게 노출되지 않도록 권한을 제어합니다.
- 지연 시간과 안전성 간 균형: 안전성 검사가 고도화될수록 API 응답 지연 시간(Latency)이 증가할 수 있으므로, 업무 중요도에 따라 검증 강도를 차등 적용합니다.
자주 묻는 질문
Q. OpenAI와 Anthropic 중 어느 회사의 모델이 더 안전한가요?
두 회사는 강점이 다릅니다. Anthropic은 헌법적 AI 기반으로 유해 콘텐츠 및 탈옥 시도에 대해 원천 거부하는 경향이 강해 규제 준수가 엄격한 금융·의료 분야에 선호되며, OpenAI는 유연한 완화 정책과 정교한 거버넌스를 갖춰 다양한 개발자 에코시스템에서 폭넓게 활용됩니다.
Q. ASL-3 등급이란 구체적으로 무엇을 의미하나요?
Anthropic의 ASL-3는 모델이 악의적인 사이버 공격이나 생물학적 무기 제조를 실질적으로 가속할 수 있는 잠재력을 가질 때 부여되는 등급으로, 가중치 암호화 저장, 다중 승인 배포 통제 등 최고 수준의 물리적·디지털 보안 조치가 의무화됩니다.
Q. 일반 기업 개발자가 안전성 평가 지표를 확인하려면 어떻게 해야 하나요?
각 사가 신규 모델 출시 시 공식 발간하는 '시스템 카드(System Card)' 및 독립 평가 기관(Artificial Analysis 등)의 안전성·환각률 벤치마크 데이터를 통해 잔여 위험 수준과 거부율 통계를 직접 확인할 수 있습니다.
참고자료
- OpenAI, Preparedness Framework Version 2 (공식 문서, 2025-04-15)
- Anthropic, Responsible Scaling Policy 공식 페이지
- Dario Amodei, "We Must Pace the Frontier"
- CoinDesk, "OpenAI, Anthropic and Musk converge on an unusual idea: slow the AI race"
- TechCrunch, "OpenAI releases its official report on the Hugging Face breach"