llm-d 1.0 사용법: Kubernetes Quickstart 배포 가이드

llm-d 1.0은 모델을 내려받아 개인 PC에서 실행하는 앱이 아니라, Kubernetes 클러스터에서 여러 LLM 모델 서버의 추론 요청을 조정하는 분산 추론 스택입니다. 공식 Quickstart는 저장소와 도구를 준비하고, 라우터와 모델 서버를 배포한 뒤 테스트 요청으로 응답을 확인하는 흐름입니다. 아래 기능 설명은 2026년 10월 22일 기준 공식 v1.0 발표를, 배포 예시는 공식 Quickstart를 기준으로 정리했습니다.
llm-d 1.0은 무엇을 하는가
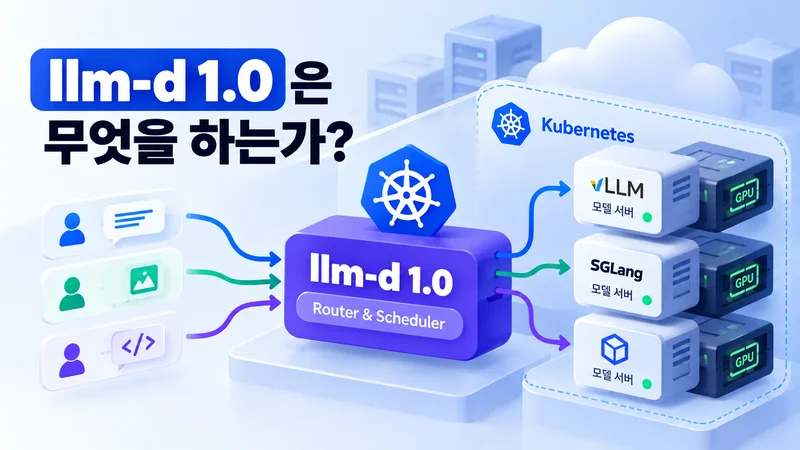
LLM 추론은 모델이 입력을 받아 답변을 생성하는 과정입니다. llm-d는 Kubernetes에서 여러 모델 서버와 가속기 자원을 활용하고, 요청을 적절한 서버로 전달하도록 돕는 운영 계층입니다. vLLM이나 SGLang 같은 모델 서버를 대체하는 모델 자체가 아니라, 모델 서버와 라우팅·스케줄링 기능을 함께 구성하는 인프라에 가깝습니다.
v1.0의 주요 기능
공식 v1.0 발표는 테넌트별 우선순위와 공정성을 고려하는 요청 제어, 안정화된 v1 구성 API, 무중단 업데이트를 위한 운영 기능, 세션과 대화 차례를 고려하는 라우팅을 소개합니다. 접두부 캐시 인식 라우팅과 KV 캐시 오프로딩도 llm-d가 제공해 온 추론 효율 기능입니다. 세부 기능의 사용 가능 여부와 동작은 배포 구성, 모델 서버, 하드웨어에 따라 달라집니다.
누구에게 맞는 도구인가
자체 모델을 Kubernetes에서 운영하며 여러 요청 유형과 가속기 자원을 관리하는 플랫폼·인프라 팀에 적합합니다. 개인 PC에서 챗봇을 간단히 실행하거나 모델 학습·미세조정을 시작하려는 용도의 도구는 아닙니다. llm-d 자체가 모델 가중치나 클러스터를 제공하지 않으므로 클러스터와 모델 서버를 준비해야 합니다.
배포 전에 확인할 준비물
기본 구성 요소
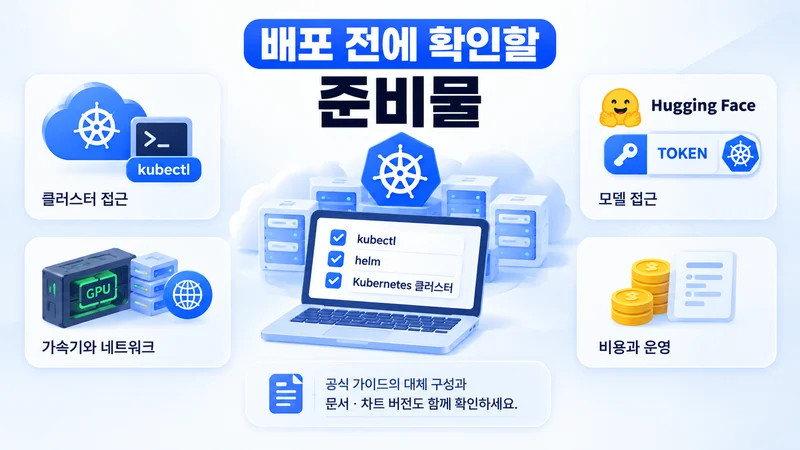
공식 Quickstart는 kubectl과 helm, 접근 가능한 Kubernetes 클러스터를 전제로 합니다. 기본 모델 서버 예시는 NVIDIA GPU에서 vLLM으로 Qwen/Qwen3-32B 복제본 2개를 실행합니다. 이는 예제 기본값이며 모든 환경에서 필요한 모델이나 노드 수를 뜻하지 않습니다. 공식 가이드는 AMD·Intel·TPU·CPU 대안 구성도 안내합니다.
클러스터 접근: 현재 컨텍스트와 네임스페이스를 확인하고 필요한 배포 권한을 준비합니다.
가속기와 네트워크: 선택한 모델과 서빙 구성에 맞는 실행 환경과 클러스터 네트워크를 마련합니다.
모델 접근: Hugging Face에서 모델을 받는 구성이라면 유효한 토큰을 Kubernetes Secret으로 등록합니다.
비용과 운영: 모델 가중치 다운로드, 가속기 사용, 스토리지와 네트워크 비용을 고려하고 테스트 후 리소스를 정리합니다.
가속기별 설정은 공식 가이드의 대체 구성을 확인하세요. Quickstart는 변경될 수 있으므로 실제 배포 전에 저장소의 현재 문서와 선택한 차트 버전이 맞는지 확인해야 합니다.
공식 Quickstart로 배포하는 순서
1. 저장소와 기본 환경을 준비합니다
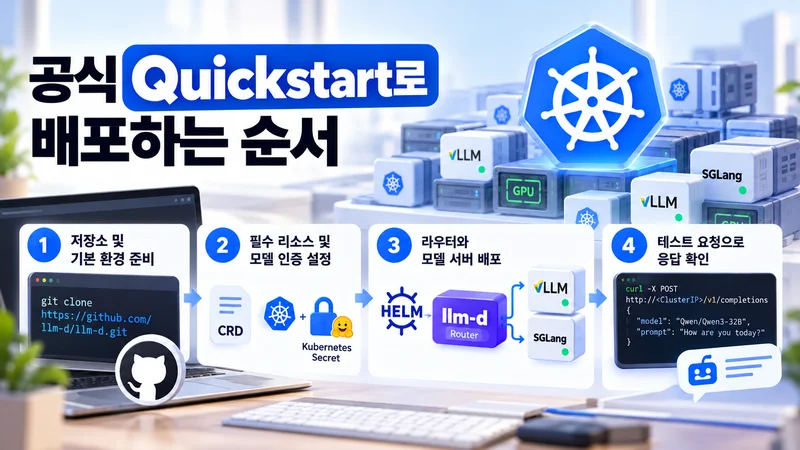
공식 Quickstart는 저장소의 main 브랜치를 기준으로 안내합니다. 다음 명령으로 저장소를 내려받고 필요한 환경 변수를 불러옵니다. 실행 전에는 대상 클러스터에 연결된 kubectl인지 확인하세요.
export branch="main"
git clone https://github.com/llm-d/llm-d.git
cd llm-d
git checkout "${branch}"
export REPO_ROOT=$(realpath $(git rev-parse --show-toplevel))
source "${REPO_ROOT}/guides/env.sh"
export GUIDE_NAME="quickstart"
export NAMESPACE=llm-d-quickstart
2. 필수 리소스와 모델 인증 정보를 설정합니다
가이드는 Gateway API Inference Extension의 CRD(Custom Resource Definition, Kubernetes에 새 리소스 유형을 추가하는 정의)를 설치하고 대상 네임스페이스를 만듭니다. 이어 모델 다운로드에 사용할 Hugging Face 토큰을 llm-d-hf-token Secret으로 등록합니다. 아래 입력 명령은 토큰을 화면에 표시하지 않지만, 조직의 비밀 정보 관리 정책도 따라야 합니다.
kubectl apply -f https://github.com/kubernetes-sigs/gateway-api-inference-extension/${GAIE_URL}/v1-manifests.yaml
kubectl create namespace "${NAMESPACE}" --dry-run=client -o yaml | kubectl apply -f -
read -rsp "Hugging Face token: " HF_TOKEN
echo
kubectl create secret generic llm-d-hf-token \\
  --from-literal="HF_TOKEN=${HF_TOKEN}" \\
  --namespace "${NAMESPACE}" \\
  --dry-run=client -o yaml | kubectl apply -f -
unset HF_TOKEN
3. 라우터와 모델 서버를 배포합니다
라우터는 요청을 모델 서버로 전달하고 부하 분산을 담당합니다. 공식 Quickstart 예시는 Standalone Mode 라우터를 설치한 뒤 NVIDIA GPU용 vLLM 모델 서버 구성을 적용합니다. 다른 하드웨어를 사용할 경우 해당 하드웨어의 대체 구성을 선택하고 모델 이름도 그 구성에 맞춰야 합니다.
helm install "${GUIDE_NAME}" \\
  "${ROUTER_STANDALONE_CHART}" \\
  -f guides/recipes/router/base.values.yaml \\
  -f guides/optimized-baseline/router/optimized-baseline.values.yaml \\
  -n "${NAMESPACE}" --version "${ROUTER_CHART_VERSION}"
kubectl apply -n "${NAMESPACE}" \\
  -k guides/optimized-baseline/modelserver/gpu/vllm/base/
bash "${REPO_ROOT}/guides/scripts/wait-for-pods-ready.sh" \\
  -l llm-d.ai/guide=optimized-baseline -n "${NAMESPACE}"
모델 가중치를 내려받는 데 시간이 걸릴 수 있습니다. 파드가 준비되지 않으면 kubectl get pods -n "$NAMESPACE"로 상태를 확인하고 이미지 다운로드, 메모리 부족, 인증 실패와 관련된 이벤트와 로그를 살펴보세요.
4. 테스트 요청으로 응답을 확인합니다
Quickstart는 클러스터 내부에서 라우터 서비스의 ClusterIP를 조회한 뒤 임시 curl 컨테이너에서 /v1/completions로 요청을 보냅니다. 서비스가 클러스터 외부에 공개된 구성이라면 접근 방식과 인증을 별도로 설정해야 합니다.
export IP=$(kubectl get service "${GUIDE_NAME}-epp" \\
  -n "${NAMESPACE}" -o jsonpath='{.spec.clusterIP}')
kubectl run curl-debug --rm -it \\
  --image=cfmanteiga/alpine-bash-curl-jq \\
  --namespace="${NAMESPACE}" --env="IP=${IP}" -- /bin/bash
임시 셸 안에서 실제 배포 모델 이름과 일치시켜 요청합니다.
curl -X POST "http://${IP}/v1/completions" \\
  -H 'Content-Type: application/json' \\
  -d '{"model":"Qwen/Qwen3-32B","prompt":"How are you today?"}'
요청이 실패하면 서비스 주소, 네임스페이스, 모델 이름과 파드 준비 상태부터 확인하세요. 응답 지연과 처리량은 모델, 가속기, 동시 요청, 캐시 적중률에 좌우됩니다. Quickstart 성공만으로 운영 성능이 보장되지는 않습니다.
Quickstart는 클러스터 내부에서 동작을 확인하는 출발점입니다. 외부 트래픽을 받기 전에는 인증, 네트워크 노출, 리소스 한도, 관측과 장애 복구를 별도로 설계하세요.
다음 단계와 운영 시 주의점
기본 응답 이후 확장하기
첫 응답을 확인한 뒤 실제 병목을 측정하고 필요한 기능부터 추가하세요. 반복되는 입력 문맥이 있는 서비스는 접두부 캐시 인식 라우팅을 검토할 수 있고, 가속기 메모리가 부족한 환경에서는 KV 캐시 오프로딩을 살펴볼 수 있습니다. 입력 문맥 처리와 토큰 생성을 분리해 운영해야 한다면 Prefill/Decode 분리 구성을 검토할 수 있습니다. 기능별로 모델 서버, 네트워크와 배포 조건이 다릅니다.
대기시간: 평균뿐 아니라 P95 같은 꼬리 지연과 요청 유형별 차이를 관찰합니다.
캐시: 적중률과 메모리 사용량을 함께 보고 업무 입력이 실제로 재사용되는지 확인합니다.
공유 자원: 테넌트별 우선순위와 공정성 정책을 설정해 배경 작업과 대화형 요청을 함께 관리합니다.
업데이트: 무중단 업데이트 기능을 사용하더라도 실제 모델 서버·차트·클러스터 조합에서 검증합니다.
배포 예제는 운영 트래픽에 대한 성능 약속이 아닙니다. 경쟁사 사례에 나온 에이전트 수나 비용 비교는 특정 환경의 결과이므로 자기 환경의 용량 산정값으로 그대로 사용하지 마세요. 지연과 처리량은 실제 모델, 가속기와 요청 부하를 반영해 벤치마크해야 합니다.
테스트 후 리소스 정리
Quickstart 리소스를 더 사용하지 않는다면 Helm 릴리스를 제거하고 테스트 네임스페이스를 삭제합니다. 네임스페이스에 별도 업무 리소스를 함께 만들었다면 먼저 확인하세요. 클러스터나 가속기 인스턴스가 클라우드에서 계속 실행 중이면 Kubernetes 리소스를 정리한 뒤에도 비용이 발생할 수 있으므로 클라우드 자원 상태도 점검합니다.
helm uninstall "${GUIDE_NAME}" -n "${NAMESPACE}"
kubectl delete namespace "${NAMESPACE}"
자주 묻는 질문
Q. llm-d 1.0은 Ollama처럼 PC에서 바로 실행하나요?
아닙니다. llm-d는 Kubernetes 클러스터에서 여러 모델 서버의 추론 요청을 조정하는 인프라 스택입니다. 개인 PC에서 로컬 모델을 실행하려는 용도와는 다릅니다.
Q. GPU가 반드시 필요한가요?
공식 Quickstart의 기본 경로는 NVIDIA GPU와 vLLM 구성이지만, 문서에는 CPU·AMD·Intel·TPU 대안 구성도 안내되어 있습니다. 지원 모델과 실행 조건은 사용할 가속기의 가이드에서 확인하세요.
Q. 배포만 하면 수천 개 에이전트를 처리할 수 있나요?
그렇게 단정할 수 없습니다. 동시 에이전트 수는 모델, 가속기 수, 요청 길이, 캐시 적중률과 부하에 따라 달라집니다. 자체 환경을 반영한 벤치마크로 용량을 확인하세요.
Q. 모델 가중치 다운로드가 오래 걸리거나 실패하면 어떻게 하나요?
모델 크기에 따라 초기 다운로드에 시간이 걸릴 수 있습니다. 파드 이벤트와 로그에서 인증 오류, 다운로드 제한, 스토리지 여유 공간과 네트워크 접근을 확인하고 모델 토큰 Secret이 대상 네임스페이스에 있는지 점검하세요.
Q. 확인과 정리는 어디서 시작하면 되나요?
공식 Quickstart에서 현재 명령과 기본 배포 경로를 확인하고, 테스트를 마친 환경은 가이드의 제거 명령에 따라 정리하세요. 클라우드 가속기와 클러스터 비용은 해당 제공자의 리소스 상태도 확인해야 합니다.

