Raon-1 mini 사용법: 신청부터 로컬 실행까지

목차
Raon-1 mini를 빠르게 써보려면 공식 플레이그라운드를 이용하고, 직접 실행하려면 Hugging Face에서 모델 접근을 신청한 뒤 모델 카드의 설치 설정을 따르면 됩니다. 아래 내용은 2026년 11월 1일 확인 기준이며, 이 모델은 정식판이 아닌 프리뷰입니다.
Raon-1 mini는 어떤 모델인가
30B-A4B 표기와 실제 파라미터 수
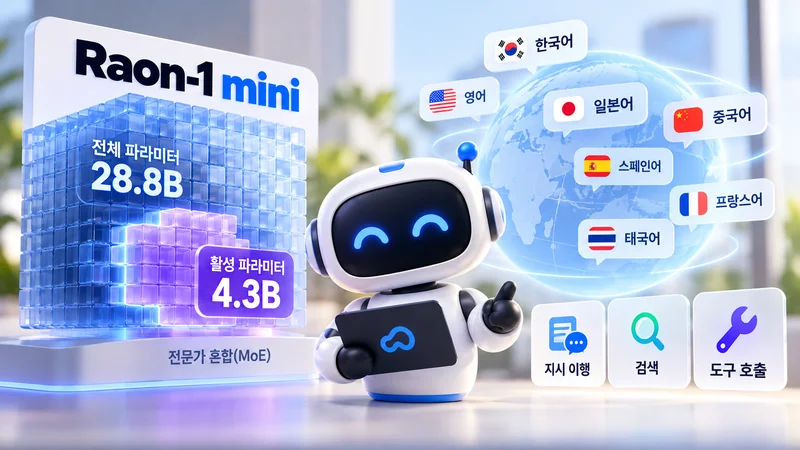
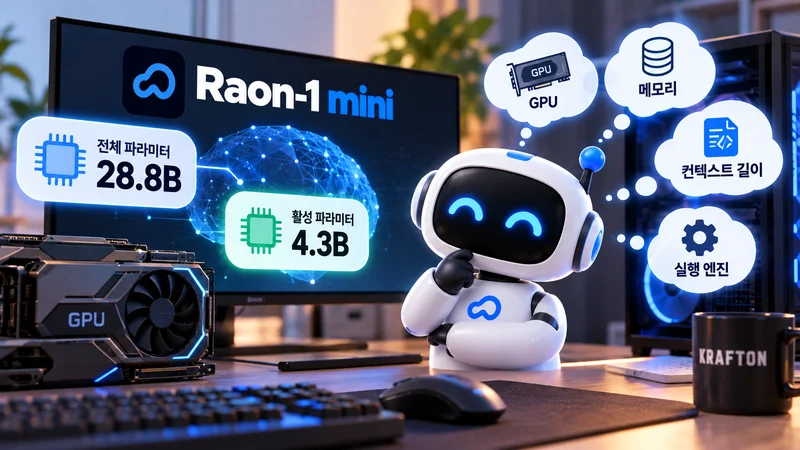
Raon-1 mini는 크래프톤이 공개한 전문가 혼합(MoE, 토큰마다 일부 전문가만 계산에 참여하는 구조) 기반 언어 모델입니다. 공식 소개 페이지의 30B-A4B는 규모를 반올림한 표기입니다. 최신 Hugging Face 모델 카드에는 전체 파라미터가 28.8B, 토큰당 활성 파라미터가 4.3B라고 기재되어 있어 서로 모순되지 않습니다. 활성 파라미터가 전체 모델 크기나 필요한 메모리를 뜻하는 것은 아닙니다.
프리뷰와 컨텍스트 한도 이해하기
프리뷰는 최종 출시 전 버전이므로 사양과 평가 결과가 바뀔 수 있습니다. 모델 카드에는 최대 262,144토큰 컨텍스트가 안내되어 있지만, 실제로 한 번에 처리 가능한 길이는 실행 백엔드와 메모리 여유에 따라 달라집니다. 25개 레이어 가운데 18개는 Raon Delta Attention, 7개는 Gated MLA를 사용하며, 일부 레이어만 KV 캐시를 유지합니다. 긴 문서를 넣을 때는 카드의 최대값만 보고 설정하지 말고 사용 환경의 한도를 확인하세요.
공식 카드 기준은 전체 28.8B, 토큰당 활성 4.3B입니다. 소개 페이지의 30B-A4B는 반올림한 규모 표기이며, 4.3B만큼의 메모리만 있으면 된다는 뜻은 아닙니다.
웹에서 체험할 때 확인할 점
가입 체험과 로그인 없는 체험
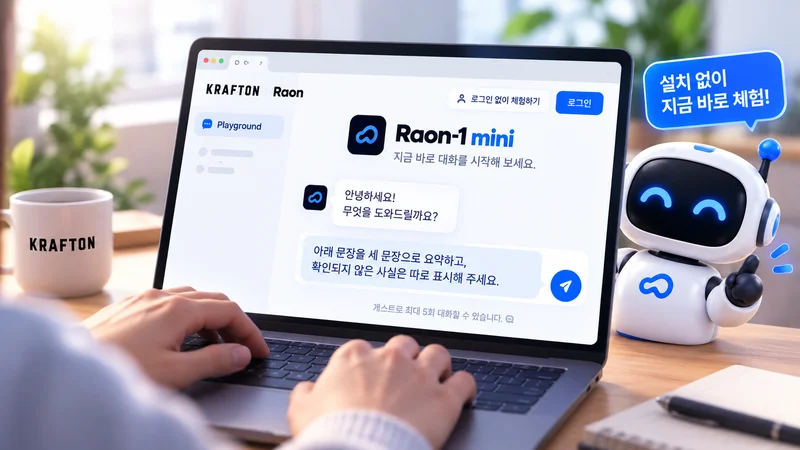
Raon 공식 페이지는 로그인 없이 체험하는 경로와 API 가입 신청 경로를 안내합니다. 공식 서비스는 모델 공개를 기념해 API를 제한 기간 무료로 제공한다고 설명하며, 사용자별 토큰 사용량이나 요청 횟수 제한이 적용될 수 있다고 밝힙니다. 따라서 계속 무료라고 단정할 수 없고, 요금이나 한도가 바뀔 가능성도 고려해야 합니다.
게스트 제한과 대화 보존은 화면에서 확인
현재 공식 페이지에서 로그인 없는 체험 링크는 확인되지만, 게스트 사용 횟수, 대화가 계정으로 이전되는지, 새로고침 후 대화가 남는지는 확정된 안내로 확인되지 않습니다. 민감한 내용을 입력하기 전에는 이용 시점의 공식 화면과 서비스 약관을 확인하고, 필요한 대화는 별도로 보관하세요. 화면의 체험 방식이나 제한은 서비스 업데이트에 따라 달라질 수 있습니다.
Hugging Face에서 접근 신청하기
가중치 저장소 접근 절차
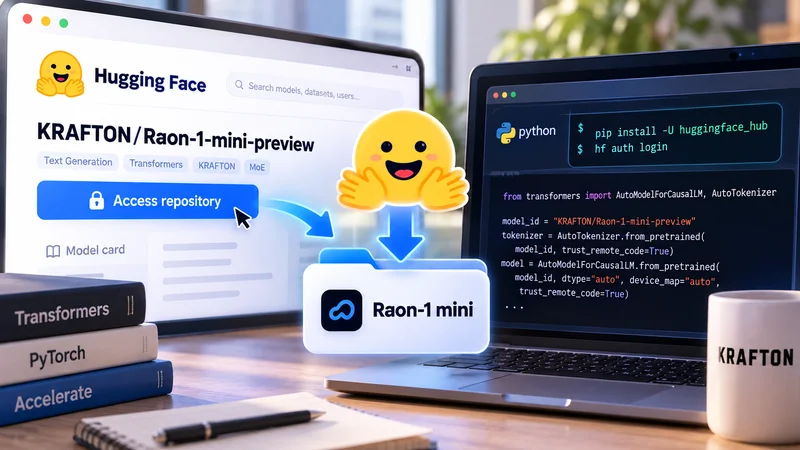
로컬 실행용 모델 저장소는 접근 신청이 필요한 게이트 방식입니다. 공식 모델 카드에서 접근을 신청하고, Hugging Face 계정으로 인증한 뒤 내려받습니다. 카드 안내상 승인은 자동이며 Raon-1 mini 프리뷰 저장소들에 적용됩니다. 신청 전에 계정 로그인이 되어 있는지 확인하고, 실행 환경에서도 같은 계정으로 인증해야 다운로드 단계에서 권한 오류를 줄일 수 있습니다.
- Hugging Face의 Raon-1 mini 프리뷰 모델 카드에서 접근을 신청합니다.
- 터미널에서 Hugging Face Hub 도구를 설치하고 계정 인증을 진행합니다.
- 선택한 실행 방식에 맞춰 공식 카드의 의존성 버전과 서버 설정을 적용합니다.
- 모델이 로드되면 짧은 입력으로 응답과 메모리 사용을 확인한 뒤 작업을 늘립니다.
라이선스는 모델 파일과 호스팅 서비스를 나눠 읽기
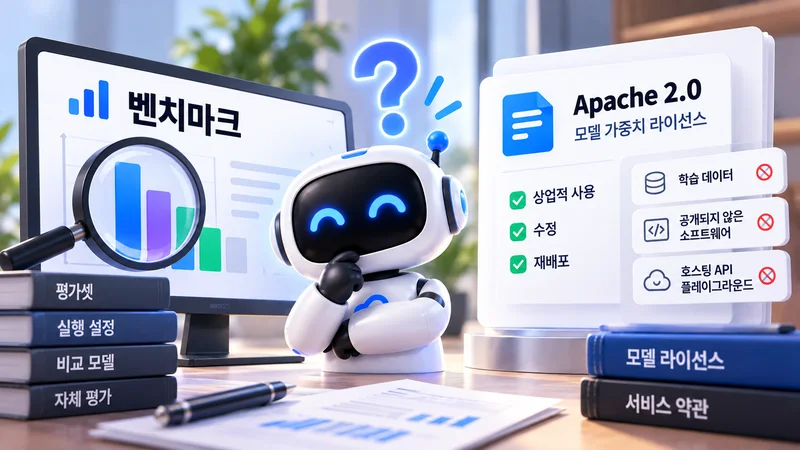
모델 카드의 라이선스는 저장소에서 배포하는 모델 가중치와 구성 요소에 대한 Apache 2.0입니다. 해당 범위에서는 사용·수정·재배포와 상업적 이용이 허용됩니다. 다만 학습 데이터, 공개되지 않은 학습 방법과 소프트웨어까지 같은 라이선스에 포함되는 것은 아닙니다. 공식 API와 플레이그라운드도 Apache 2.0 대상이 아니며 별도의 호스팅 서비스 이용 조건이 적용됩니다.
공식 모델 카드 설정으로 로컬 실행하기
Transformers 설치 버전
간단한 Python 실행에는 카드가 지정한 Python 3.12 가상환경과 Transformers, Accelerate 버전을 사용합니다. 모델 로딩 시 원격 모델 코드를 허용하는 옵션이 필요하므로, 모델 출처를 확인한 뒤 공식 저장소의 코드로 실행하세요.
uv venv --python 3.12 --seed
source .venv/bin/activate
pip install \
  "transformers==5.16.1" \
  "accelerate==1.15.0"
pip install -U huggingface_hub
hf auth login
vLLM 베타 서버 설정
OpenAI 호환 API 서버가 필요하면 모델 카드의 vLLM 베타 설정을 참고할 수 있습니다. 일반 MXFP8 설정은 카드에서 KRAFTON 포크의 raon-1-mini-preview 브랜치를 지정하고, 컨텍스트 길이와 동시 시퀀스 수 등을 설정합니다. 이 설정은 NVIDIA B300에서 테스트됐다고 명시되어 있으므로 다른 GPU에서 같은 성능이나 실행 가능성을 보장하지 않습니다. RTX 5090용 NVFP4 설정은 별도 프로필이며 CUDA Toolkit 13과 nvcc 경로 설정 등 전제 조건을 확인해야 합니다.
VLLM_REF="raon-1-mini-preview"
uv venv --python 3.12
source .venv/bin/activate
VLLM_USE_PRECOMPILED=1 uv pip install \
  "vllm @ git+https://github.com/krafton-ai/vllm.git@${VLLM_REF}"
vllm serve KRAFTON/Raon-1-mini-preview \
  --host 127.0.0.1 \
  --port 8000 \
  --served-model-name Raon-1-mini-preview \
  --max-model-len 262144 \
  --max-num-batched-tokens 16384 \
  --max-num-seqs 128 \
  --gpu-memory-utilization 0.85 \
  --kv-cache-dtype fp8_e4m3 \
  --enable-prefix-caching \
  --spec-method dflash \
  --spec-model KRAFTON/Raon-1-mini-preview-dflash2 \
  --spec-tokens 7 \
  --reasoning-parser raon_1 \
  --enable-auto-tool-choice \
  --tool-call-parser raon_1
카드의 샘플링 기본값은 temperature 1.0, top_p 0.95, top_k 20, repetition penalty 1.0입니다. 추론(thinking) 모드는 기본적으로 켜도록 권장합니다. 코딩·수학 작업의 presence penalty는 0, 일반 대화·요약·질의응답은 1.5가 카드에 제시된 값입니다. 카드에는 첫 실행 때 커널 컴파일이 진행되어 시간이 더 걸릴 수 있다고도 안내합니다.
메모리와 운영 규모를 판단하는 법
활성 파라미터 수만으로 GPU를 고르지 않기
실제 메모리 요구량은 전체 가중치 크기, 정밀도 또는 양자화 방식, 컨텍스트 길이, 동시 요청 수에 좌우됩니다. 모델 카드에는 MXFP8 및 NVFP4 선택지가 있고, NVFP4 변형은 RTX 5090 단일 GPU(32GB VRAM) 추론 구성을 안내합니다. 이것은 해당 설정에서의 안내이지, 긴 컨텍스트와 많은 동시 요청까지 무조건 가능한 보장은 아닙니다. 32GB GPU에서 기본 MXFP8 모델을 쓸 경우 카드 안내는 CPU 오프로딩과 device_map="auto"를 제시합니다.
요청량과 컨텍스트를 실제 부하에 맞추기
개인 테스트는 짧은 입력과 적은 동시 요청부터 시작하고, 컨텍스트나 배치 크기를 높일 때 GPU 메모리와 대기 시간을 함께 측정하세요. 여러 사용자의 요청을 받는 Kubernetes 환경에 배포한다면 모델 서버의 동시성·자원 배분 요구를 먼저 정리한 뒤 llm-d Kubernetes 배포 가이드의 운영 구성을 검토할 수 있습니다. 로컬에서 확인한 단일 요청 결과를 서비스의 처리량으로 바로 환산하지 마세요.
4.3B는 토큰당 활성 파라미터 수입니다. 필요한 메모리는 전체 가중치와 정밀도·양자화, 컨텍스트 길이, 동시성 설정을 함께 보고 판단해야 합니다.
자주 묻는 질문
Q. Raon-1 mini는 무료로 계속 쓸 수 있나요?
공식 서비스는 API 이용을 제한 기간 무료로 제공한다고 안내합니다. 사용자별 요청·토큰 제한이 있을 수 있으며, 영구 무료라고 보장하지 않으므로 이용 시점의 서비스 화면과 약관을 확인하세요.
Q. 로그인 없이 체험하면 대화 횟수가 정해져 있나요?
로그인 없이 체험하는 링크는 있지만, 공식 페이지에서 게스트 횟수 제한이나 대화 보존 방식을 확인할 수 없습니다. 체험 화면과 약관에서 최신 조건을 확인하세요.
Q. 30B-A4B와 28.8B·4.3B는 서로 다른 사양인가요?
아닙니다. 30B-A4B는 반올림한 소개 표기이고, 최신 모델 카드의 전체 28.8B와 토큰당 활성 4.3B가 더 구체적인 파라미터 수치입니다.
Q. Apache 2.0이면 API도 같은 조건으로 쓸 수 있나요?
아닙니다. Apache 2.0은 Hugging Face 저장소에서 제공하는 모델 구성 요소에 적용됩니다. 호스팅 API와 플레이그라운드는 별도 서비스 약관을 따릅니다.
Q. 4.3B 모델이니 4.3B 파라미터만큼의 메모리면 되나요?
아닙니다. 4.3B는 토큰 처리 중 활성화되는 파라미터 수입니다. 메모리는 전체 가중치와 실행 정밀도, 양자화, 컨텍스트 길이, 동시 요청 수에 따라 달라집니다.

