리벨리온 NPU와 llm-d 연동 조건 및 P/D 구성 확인

목차
리벨리온 NPU를 llm-d와 연동할 때는 공식 기본 배포 경로와 P/D(prefill/decode) 구성을 구분해야 합니다. llm-d의 가속기 안내는 vllm-rbln 플러그인을 이용한 NPU 모델 서버 배포와 Kubernetes 장치 할당 요건을 설명합니다. 별도로 리벨리온은 RBLN-CR13에서 MiniMax-M2.7을 P/D 방식으로 실행하는 레시피를 공개했습니다. 이 레시피는 특정 하드웨어와 설정에서 확인된 사례이므로 다른 NPU나 모델에 그대로 적용된다고 볼 수 없습니다.
두 구성의 역할도 다릅니다. 리벨리온 NPU와 런타임은 모델 추론을 실행하고, llm-d는 Kubernetes 환경에서 모델 서버와 요청 라우팅을 운영하는 계층입니다. 도입 전에는 사용할 모델, 장치 할당 방식, 그리고 P/D 구성을 택한다면 서버 간 KV 캐시 전송까지 확인해야 합니다.
리벨리온 NPU와 llm-d의 연결 방식
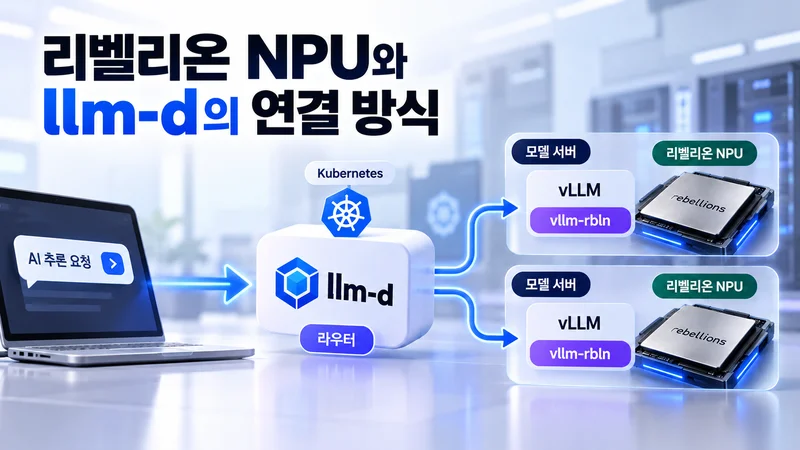
NPU는 추론 연산을, llm-d는 서버 운영을 담당
NPU(신경망처리장치)는 AI 연산을 수행하는 가속기입니다. llm-d는 여러 모델 서버를 Kubernetes에서 운영하고 요청을 서버로 전달하는 분산 추론 스택입니다. 기본 배포에서는 llm-d 라우터가 여러 모델 서버 복제본에 요청을 분산할 수 있습니다. 따라서 NPU 한 대가 llm-d의 라우터 역할을 하거나, llm-d가 NPU 런타임을 대체하는 구조는 아닙니다.
vLLM과 NPU 런타임은 vllm-rbln으로 연결
llm-d의 공식 가속기 안내는 리벨리온 NPU를 vllm-rbln vLLM 플랫폼 플러그인으로 지원한다고 설명합니다. 기본 배포 예시는 openai/gpt-oss-120b 모델 서버 복제본 두 개를 배치해 라우터가 요청을 분산하는 구성입니다. 모델 지원 여부와 실제 처리 성능은 NPU 제품, 런타임, 모델 및 설정에 따라 따로 확인해야 합니다.
기본 배포와 P/D 구성을 구분하기
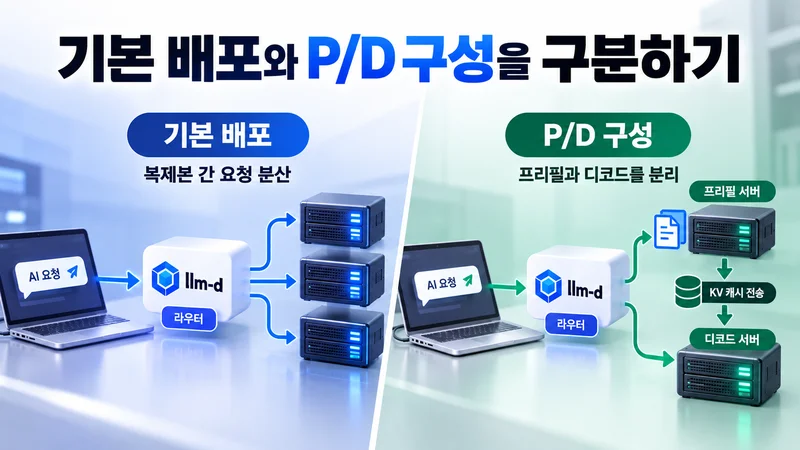
기본 경로는 복제본 간 요청 분산
기본 경로는 여러 모델 서버를 띄우고 라우터가 요청을 분산합니다. 이는 서버 복제본 간 부하 분산이며, 한 요청의 프리필과 디코드를 서로 다른 서버에서 수행하는 P/D 분리와는 다릅니다.
P/D는 프리필과 디코드를 서로 다른 서버에서 수행
프리필(prefill)은 입력 문맥을 처리해 생성에 필요한 상태를 만들고, 디코드(decode)는 다음 토큰을 생성합니다. P/D 구성에서는 두 단계를 별도 서버로 나누며, 프리필 서버에서 만든 KV 캐시를 디코드 서버로 전달해야 합니다. llm-d의 아키텍처 문서는 이 구성에 요청 라우팅과 KV 전송이 필요하다고 설명합니다.
리벨리온 문서에는 RBLN-CR13에서 MiniMax-M2.7을 실행하는 구성이 있으며, P/D 방식에서는 프리필 서버와 디코드 서버가 별도 노드에서 llm-d 라우터 뒤에 배치됩니다. 문서는 각 서버가 4개 장치를 사용한다고 밝히고, 해당 레시피가 RBLN-CR13에서 검증됐으며 설정에 따라 달라질 수 있다고 안내합니다. 이는 리벨리온의 특정 모델·하드웨어 레시피이지 llm-d의 모든 NPU 배포에 적용되는 권장 사양은 아닙니다.
체크 포인트: 기본 경로의 복제본 분산과 P/D 분리는 서로 다른 구성입니다. P/D를 검토한다면 목표 모델과 하드웨어에 맞는 공식 레시피, KV 전송 방식, 클러스터 네트워크 조건을 함께 확인하세요.
배포 전에 확인할 조건
항목 | 공식 문서에서 확인되는 내용 | 실무 점검 |
|---|---|---|
llm-d NPU 기본 경로 | RBLN NPU Operator와 Kubernetes 1.34, DRA API | 클러스터 버전, 드라이버, 장치 할당 상태 |
장치 선택 | DRA DeviceClass와 제품 선택 조건 | 요청한 제품이 의도한 NPU로 할당되는지 |
vLLM 런타임 | vllm-rbln 플러그인 | 모델·런타임 버전·실행 설정 호환성 |
P/D 구성 | 별도 서버와 KV 캐시 전송 필요 | 라우팅, 네트워크 경로, 실제 KV 전송 여부 |
Kubernetes DRA와 NPU 제품 선택
DRA(Device Resource Allocation)는 Kubernetes에서 가속기 같은 장치를 할당하는 인터페이스입니다. llm-d의 리벨리온 기본 배포 안내는 RBLN NPU Operator와 resource.k8s.io/v1 DRA API를 요구하며, Kubernetes 1.34를 명시합니다. 해당 안내는 NPU를 확장 리소스가 아닌 DRA로 요청하고, 제품에 맞는 선택 조건을 확인하도록 설명합니다. 이 버전 요건은 llm-d가 안내하는 기본 NPU 배포 경로의 조건으로 이해해야 합니다.
P/D 구성은 KV 전송 경로까지 검증
프리필 서버에서 디코드 서버로 KV 캐시가 전달돼야 P/D 구성이 성립합니다. llm-d 아키텍처 문서는 고성능 환경의 KV 전송에 RDMA 연결을 설명하고, RDMA가 없을 때 TCP 전송은 효율적이지 않아 테스트·개발 용도에 한정하라고 안내합니다. 실제 리벨리온 구성에 필요한 커넥터, 장치, 네트워크 설정은 대상 하드웨어와 레시피의 지침을 확인해야 합니다. 모든 리벨리온 P/D 배포에 동일한 RoCE 장치 구성이 필요하다고 일반화하지 마세요.
성능을 판단하기 전에 볼 지표
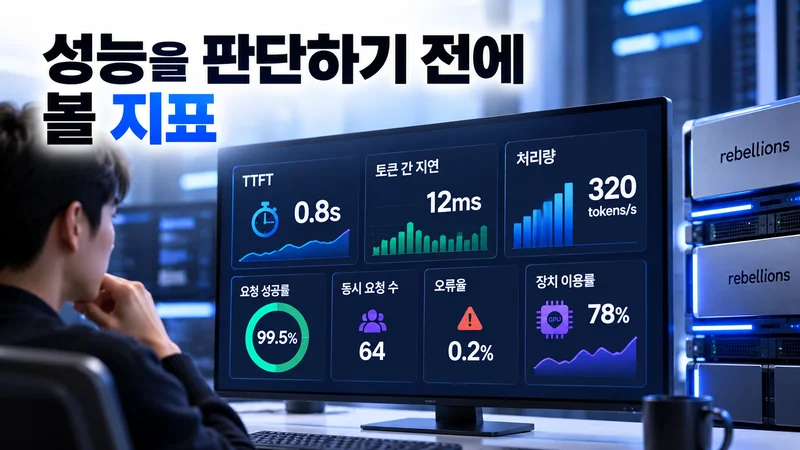
요청 성공과 P/D 동작은 따로 확인
API 요청이 성공해도 프리필과 디코드가 다른 서버에서 동작했거나 KV 캐시가 전송됐다고 단정할 수는 없습니다. 각 서버의 요청 로그와 KV 전송 관련 로그·지표를 확인해 경로를 검증하세요. 설정한 역할과 실제로 요청이 처리된 서버가 일치하는지도 살펴야 합니다.
TTFT와 토큰 간 지연을 함께 기록
TTFT(Time To First Token)는 요청 후 첫 토큰이 나올 때까지 걸린 시간이고, 토큰 간 지연은 생성 도중 토큰 사이의 시간입니다. 처리량, 동시 요청 수, 입력·출력 길이, 오류율, 장치 이용률을 함께 기록하면 병목을 구분하는 데 도움이 됩니다.
기준 구성과 P/D 구성을 동일한 모델, 입력·출력 길이, 동시성으로 비교합니다.
요청 성공률뿐 아니라 실제 KV 캐시 전송을 로그와 지표에서 확인합니다.
복제본 수와 프리필·디코드 자원 배분을 바꿨다면 같은 조건으로 다시 측정합니다.
주의: P/D 구성은 라우팅과 KV 전송 단계를 추가합니다. 모든 요청에서 지연이나 처리량이 개선된다고 단정할 수 없으므로, 실제 워크로드와 네트워크 조건으로 비교해야 합니다.
어떤 경우에 P/D 구성을 검토할까
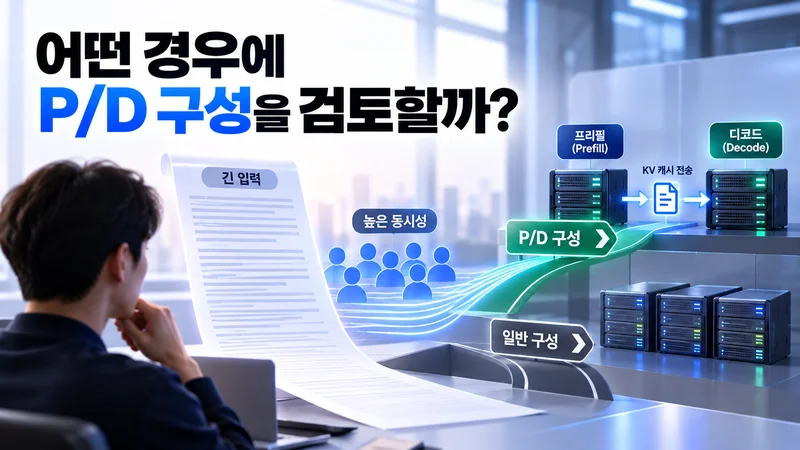
긴 입력이나 높은 동시성에서 프리필과 디코드가 서로 영향을 주는지 먼저 측정하세요. llm-d는 P/D 분리의 이점이 긴 문맥과 중대형 모델에서 커질 수 있다고 설명하지만, 모든 워크로드에 맞는 것은 아닙니다. 요청량이 적거나 단일 서버로 충분한 경우에는 별도 서버와 전송 계층의 운영 부담이 이점보다 클 수 있습니다.
처음에는 대상 모델과 하드웨어에 해당하는 공식 레시피로 장치 할당과 모델 실행부터 확인하고, 그 다음 요청 라우팅과 KV 전송을 점검하세요. 실제 서비스와 비슷한 입력 길이와 동시성으로 부하를 주고 결과를 기록합니다. 모델이나 병렬화 설정을 바꾸면 결과도 다시 검증해야 합니다. llm-d의 일반 배포 개념은 llm-d 1.0 Kubernetes 배포 가이드에서 확인할 수 있습니다.
자주 묻는 질문
Q. 리벨리온 NPU만 있으면 llm-d를 바로 쓸 수 있나요?
아닙니다. llm-d의 리벨리온 기본 경로는 NPU Operator, DRA 기반 장치 할당, 호환되는 vLLM-RBLN 런타임과 Kubernetes 설정을 전제로 합니다.
Q. llm-d에서 NPU를 쓰면 프리필과 디코드가 자동으로 분리되나요?
아닙니다. llm-d의 기본 NPU 예시는 여러 모델 서버 복제본에 요청을 분산하는 구성입니다. P/D 분리에는 역할별 서버, 라우팅, KV 캐시 전송 구성이 별도로 필요합니다.
Q. 리벨리온 NPU의 P/D 구성은 GPU보다 항상 빠르거나 저렴한가요?
공개된 배포 문서만으로 일률적인 속도나 비용 우위를 판단할 수 없습니다. 모델, 장치 수, 요청 형태, 네트워크와 운영 비용을 같은 조건에서 측정해야 합니다.
Q. API 응답이 오면 P/D 분리도 정상인가요?
그것만으로는 확인할 수 없습니다. 요청이 프리필과 디코드 역할에 맞게 전달됐는지, KV 캐시 전송이 이뤄졌는지 관련 로그와 지표를 확인하세요.

