GKE Inference Gateway 배치 추론 구성과 운영 기준

GKE Inference Gateway로 지연에 여유가 있는 추론 작업을 운영할 때는 요청을 게이트웨이에 한꺼번에 보내기보다, Pub/Sub 같은 메시지 큐에 저장한 뒤 구독자가 처리 가능한 만큼 전달하는 구조를 고려할 수 있습니다. Gateway는 모델 서버의 상태를 고려해 요청을 라우팅하고, 우선순위를 적용해 지연에 민감한 요청을 보호할 수 있습니다. 작업의 지속 보관과 소비 속도 조절, 결과 저장과 재시도는 Pub/Sub 및 구독자 같은 비동기 처리 구성요소가 맡도록 설계하는 것이 좋습니다.
배치 추론에서 Gateway가 맡는 역할
모델 서버 상태를 고려해 요청을 라우팅합니다
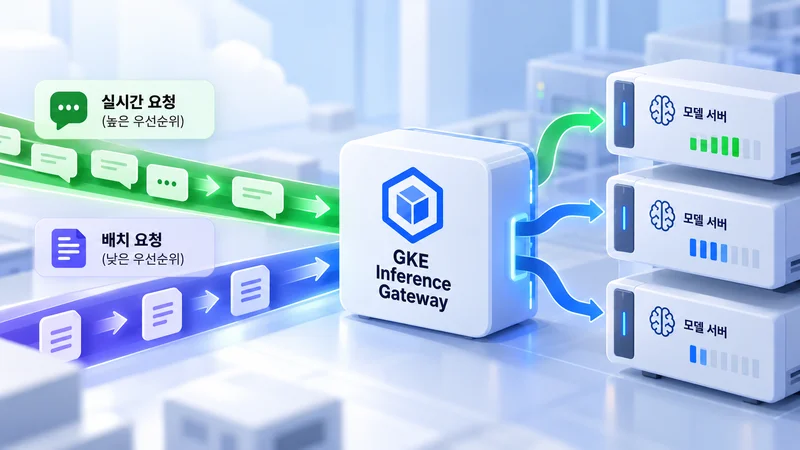
LLM(대규모 언어 모델) 추론은 요청마다 입력 길이와 연산량이 달라 요청 수만으로 서버의 실제 부하를 판단하기 어렵습니다. GKE Inference Gateway의 라우팅 구성은 모델 서버의 대기 요청 수와 KV 캐시 상태, prefix cache 정보 등 신호를 사용해 요청을 적절한 모델 복제본으로 전달할 수 있습니다. 실제로 활용되는 신호와 라우팅 동작은 배포 방식 및 모델 서버 구성에 따라 확인해야 합니다.
실시간 요청과 지연 허용 요청의 우선순위를 나눕니다
온라인 대화처럼 빠른 응답이 필요한 요청과 문서 분류·대량 요약처럼 완료가 늦어도 되는 요청은 같은 가속기 풀을 공유할 수 있습니다. 배치 작업이 몰려 실시간 요청을 밀어내지 않도록 우선순위를 설계하세요. Google Cloud 문서에 따르면 InferenceObjective의 Priority는 정수이며 값이 높을수록 더 높은 우선순위입니다. 기본값은 0이고, 자원 압박 시 명시적으로 0보다 낮게 설정한 요청은 먼저 거절될 수 있으며 HTTP 429 응답을 받을 수 있습니다.
기억할 점: 낮은 우선순위의 배치 요청은 지연될 뿐 아니라 자원 부족 상황에서 HTTP 429로 거절될 수 있습니다. 거절 응답을 작업 완료로 처리하지 말고, 재시도 전에 대기 시간을 두는 흐름을 설계하세요.
배치 작업을 안전하게 처리하는 구성
큐와 구독자가 작업을 완충합니다
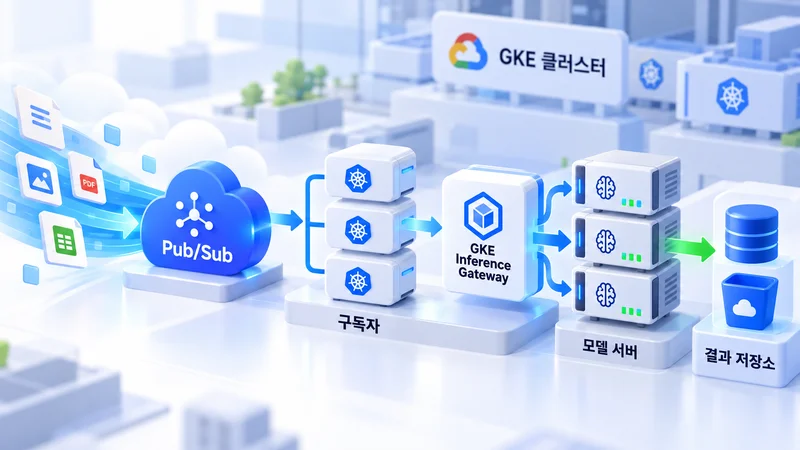
비동기 추론의 예시 흐름은 입력을 Pub/Sub 토픽에 넣고, 구독자가 메시지를 가져와 Gateway를 통해 추론 서버에 전달한 뒤, 결과를 데이터베이스나 객체 스토리지에 저장하는 방식입니다. Pub/Sub는 입력 급증을 완충하고, 구독자의 pull 및 흐름 제어 설정은 소비 속도를 조절하는 데 활용할 수 있습니다. 요청별 상태나 최종 결과를 호출자에게 돌려줘야 한다면 결과 저장소 또는 응답 토픽도 별도로 정하세요.
배치 추론과 요청 묶음을 구분합니다
대량 데이터를 정해진 시점에 처리하는 배치 추론과 여러 동시 요청을 모델 서버가 묶어 처리하는 요청 배칭은 서로 다른 개념입니다. 큐에 메시지를 넣었다고 모델 서버가 자동으로 최적 크기의 요청 묶음을 만드는 것은 아닙니다. 구독자가 메시지를 모아 서버가 처리할 수 있는 크기로 전달하도록 구성할 수 있습니다. 묶음 크기는 모델 서버 설정과 실제 처리량을 바탕으로 조정하세요. 너무 작으면 가속기를 충분히 활용하지 못하고, 너무 크면 메모리 부족(OOM)이나 작업 시간 초과가 발생할 수 있습니다.
구독자와 모델 서버를 따로 확장합니다
구독자는 메시지 읽기와 전송을 담당하므로 미전달 메시지 수 같은 큐 적체 지표를 기준으로 확장할 수 있습니다. 모델 서버는 CPU 사용률만으로 판단하기보다 추론 엔진이 제공하는 대기 요청 수 같은 지표를 활용하는 편이 적절합니다. 구독자만 크게 늘리면 모델 서버의 처리 한계를 넘어 대기와 재시도가 늘 수 있습니다. 구독자 최대 복제본 수는 추론 서버 처리량과 GPU·TPU 할당량에 맞춰 제한하세요.
| 구성 요소 | 주요 역할 | 점검 지표·설정 |
|---|---|---|
| Pub/Sub | 요청 보관과 작업 완충 | 미전달 메시지, 보존 기간, 재시도 정책 |
| 구독자 | 메시지 묶음과 Gateway 전달 | 처리량, 흐름 제어, 최대 복제본 |
| Inference Gateway | 우선순위 적용과 모델 서버 라우팅 | 429 비율, 지연, 오류 |
| 모델 서버 | 추론 수행 | 대기 요청 수, 가속기 메모리·활용률 |
운영 전 확인할 실패 처리와 용량 기준
재시도는 중복 처리와 함께 설계합니다
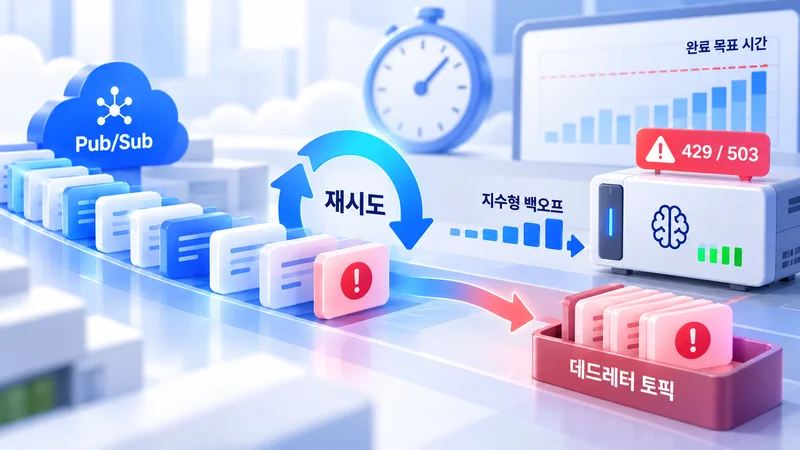
추론이 끝나기 전에 구독자의 메시지 확인 기한이 만료되면 메시지가 다시 전달되어 같은 작업이 중복 실행될 수 있습니다. Pub/Sub의 확인 기한은 처리 중 연장할 수 있으므로, 초기 확인 기한만 처리 시간보다 길게 잡는 데 그치지 말고 구독자 클라이언트의 연장 동작과 최대 연장 한도도 확인하세요. 작업 ID를 저장해 결과를 중복 기록하지 않도록 멱등성을 확보하고, 반복 실패하는 메시지는 데드레터 토픽으로 분리할 수 있습니다.
처리 목표와 큐 적체를 함께 봅니다
배치 작업의 완료 목표 시간이 짧다면 큐에 쌓인 건수만으로는 충분하지 않습니다. 구독자별 처리량, 평균·최악 추론 시간, 재시도 비율을 함께 측정해 목표 시간 안에 대기열을 비울 수 있는지 계산하세요. 실시간 트래픽이 우선되는 정책이라면 배치 작업이 지연될 수 있는 시간도 서비스 요구사항에 포함해야 합니다.
- 429·503 응답에는 지수형 백오프를 적용하고, 서버가 회복될 때까지 메시지 소비 속도를 조절합니다.
- 재시도 횟수와 작업별 마감 시간을 정하고, 반복 실패는 별도 토픽으로 보냅니다.
- Pub/Sub 확인 기한을 처리 중 연장하고, 클라이언트의 최대 연장 설정과 처리 시간을 함께 점검합니다.
- 모델 서버의 동시 처리량을 확인한 뒤 구독자의 pull 흐름 제어와 복제본 상한을 조정합니다.
도입 순서와 적용 판단
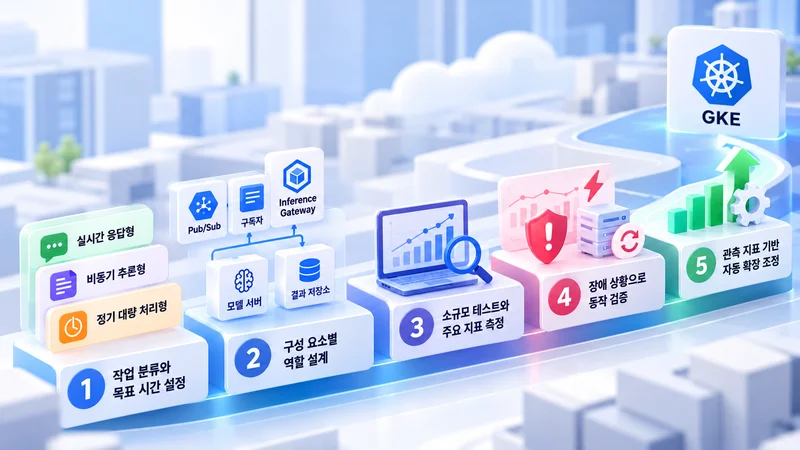
- 작업을 실시간 응답형, 비동기 추론형, 정기 대량 처리형으로 구분하고 각각의 완료 목표 시간을 정합니다.
- 입력 큐, 구독자, Gateway, 모델 서버, 결과 저장소와 실패 토픽의 책임을 나눕니다.
- 작은 트래픽으로 우선순위, 메시지 묶음 크기, 모델 서버 대기 지표를 측정합니다.
- 실시간 트래픽 급증과 모델 오류를 재현해 배치 지연·재시도·결과 중복을 확인합니다.
- 관측 지표를 기준으로 구독자와 추론 서버의 자동 확장 범위를 조정합니다.
이미 llm-d 기반 모델 라우팅 구성을 검토 중이라면 내부 글 llm-d 1.0 Kubernetes 배포 가이드에서 배포 관점을 이어서 볼 수 있습니다. GKE 비동기 추론 아키텍처와 설정 지침은 Google Cloud의 GKE 배치 추론 권장사항을, 라우팅과 우선순위 동작은 GKE Inference Gateway 개요를 참고하세요. Pub/Sub의 확인 기한과 재시도 동작은 Pub/Sub 구독 속성 문서에서 확인할 수 있습니다. 구체적인 CRD 버전과 클러스터 요구사항은 배포 시점의 공식 배포 문서에서 확인하세요.
자주 묻는 질문
Q. GKE Inference Gateway가 배치 작업 큐도 제공하나요?
Gateway는 요청 라우팅과 우선순위 처리에 초점을 둡니다. 지속 보관과 소비 속도 조절은 Pub/Sub 같은 메시징 버퍼와 구독자 구성으로 마련하는 것이 Google Cloud 비동기 추론 아키텍처의 예시입니다.
Q. 배치 요청의 Priority는 어떤 값으로 설정해야 하나요?
온라인 요청보다 낮은 우선순위를 주는 방식으로 구분할 수 있지만, 값은 서비스 중요도에 맞춰 설계해야 합니다. 0보다 낮은 값은 자원 압박 시 먼저 거절될 수 있으므로 재시도와 대기열 복귀를 고려하세요.
Q. Pub/Sub 메시지 하나를 모델 요청 하나로 보내면 되나요?
가능하지만 처리 효율이 낮을 수 있습니다. 여러 메시지를 묶을지는 모델 서버가 지원하는 요청 방식과 최적 처리량에 따라 결정하고, 메모리 부족과 지연을 측정해야 합니다.
Q. 구독자와 모델 서버는 같은 기준으로 확장하면 되나요?
일반적으로 별도 기준을 사용합니다. 구독자는 미전달 메시지 수 같은 큐 적체 지표를, 모델 서버는 추론 엔진의 대기 요청 수 같은 모델 수준 지표를 기준으로 확장하는 방식을 Google Cloud가 제시합니다.

